什麼是機器學習?
什麼是機器學習?
機器學習
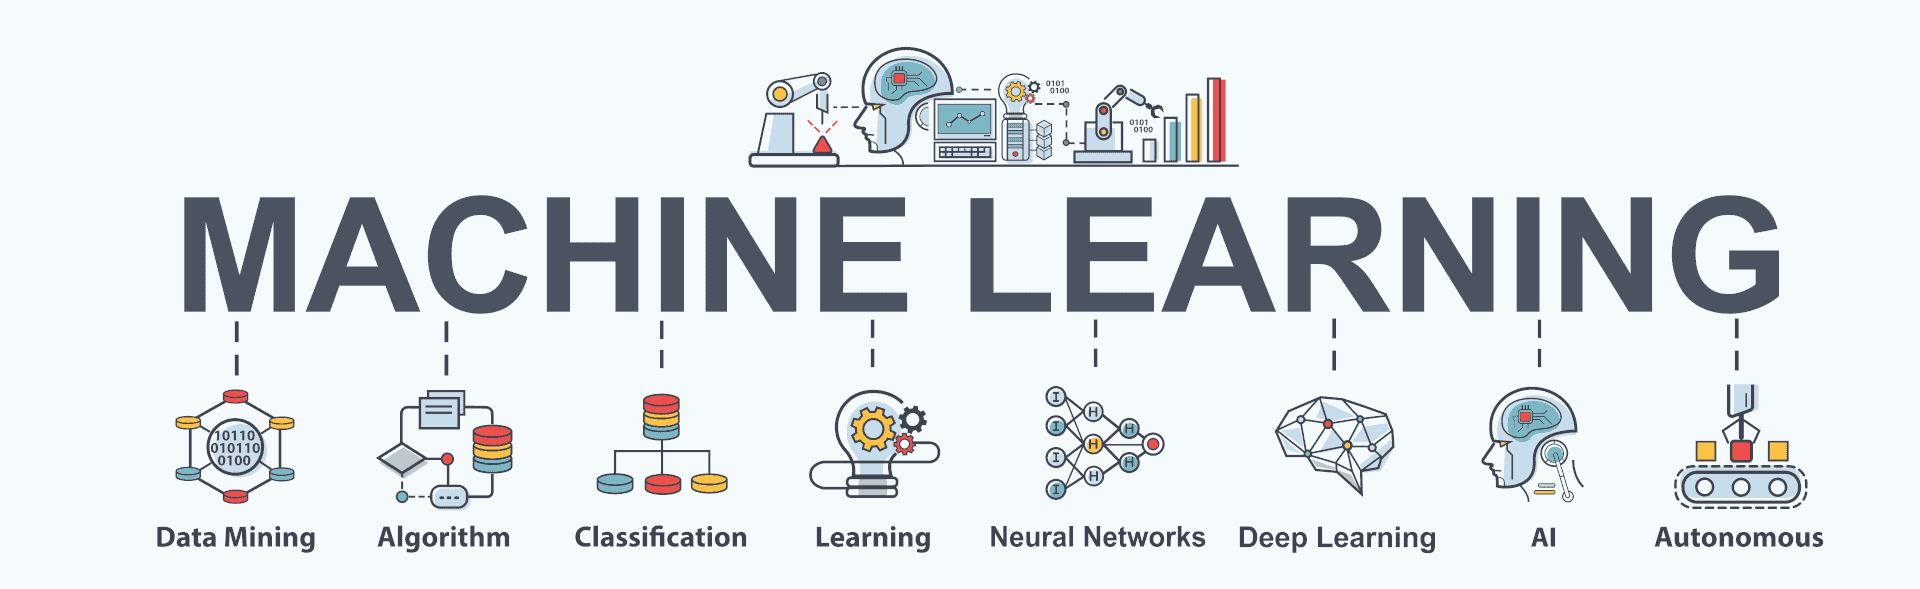
機器學習(Machine Learning)是人工智慧(AI)的一個子領域,專注於使電腦能夠從數據中學習,而無需明確編寫程式指令。換句話說,機器學習是一種讓機器透過經驗自主學習與改進的技術,類似於人類的學習方式。機器學習的常見應用包括 Facebook 等社群媒體平台,這些平台利用機器學習技術根據使用者的興趣與行為推薦朋友、社群和內容。然而,這只是機器學習應用的一小部分,該技術已廣泛應用於醫學診斷、證券分析、指紋識別、語音處理、線上購物、天氣預測等眾多領域,並持續拓展其影響力。
機器學習的運作原理
機器學習的核心概念是建立能夠從數據中學習的演算法,並利用所學知識對新數據進行預測或決策。其運作過程大致可分為以下幾個步驟:
數據收集
第一步是收集可用於訓練演算法的數據,這些數據可能來自感測器、資料庫、使用者行為記錄等多種來源。
數據預處理
收集到的數據需要經過清理與轉換,使其適用於機器學習模型。這可能包括去除錯誤或無關的資訊、填補缺失值、標準化數據格式等,以確保數據的品質與一致性。
模型訓練
接下來,經過預處理的數據將用於訓練機器學習模型。在這個階段,演算法會分析數據中的模式與特徵,並學習如何基於這些模式進行預測。
模型評估
模型訓練完成後,需要透過測試數據集來評估其準確性與效能,確保模型能夠在未見過的數據上維持良好表現。
模型應用
最後,經過優化與驗證的機器學習模型將被部署,正式應用於實際場景中,以處理新數據並提供決策建議或預測結果。
機器學習的類型
雖然機器學習經常與人工智慧(AI)一起討論,但並非所有 AI 應用都涉及機器學習。機器學習類似於人類的學習過程,需要透過訓練數據來識別模式並進行預測。根據學習方式的不同,機器學習主要可分為四種類型:監督式學習(Supervised Learning)、非監督式學習(Unsupervised Learning)、半監督式學習(Semi-Supervised Learning)和強化學習(Reinforcement Learning)。
監督式學習(Supervised Learning)
監督式學習,是機器學習中的一種方式,它將所有的資料加以「標註」(Label),告訴機器哪個答案是對的,哪個答案是錯的,告訴機器甚麼是正確答案後,藉此教導機器學習如何判斷出標準結果。以最常見的貓、狗辨識為例,匯入圖像樣本後,須由「人工」進行標註,將圖像樣本中的貓狗標示出來,讓機器學習認識貓與狗的外觀與特徵(Feature),例如耳朵、四肢、體型等,而後機器就能依照資料中的分析模式進行辨識及預測。
由於監督式學習的操作,在事前須仰賴人力將圖像中進行特徵標註,若要讓模型達到預期的準確度,就須提供完整、大量的資料給機器學習,因此監督式學習準確度較高,但作業量相對大、執行面也相對繁瑣。
非監督式學習(Unsupervised Learning)
就如同字面上的「非」字,非監督式學習的訓練,它沒有給機器事先標註過的訓練範例,而是讓機器自動尋找資料的特徵並自行分類。
例如提供機器大量貓和狗的圖片學習,但事前並沒有告訴機器哪些是貓哪些是狗,而是直接讓機器自動區分貓狗潛在特徵並分類。非監督式學習常見的功能可為分群(Clustering)、關聯(Association)與降維(Dimension Reduction),在資料探勘初期是好用的工具,對人力的負擔較小,但對機器而言卻相反,且不重要的特徵容易被過度放大,預測結果容易出現偏差。
例如提供機器大量貓和狗的圖片學習,但事前並沒有告訴機器哪些是貓哪些是狗,而是直接讓機器自動區分貓狗潛在特徵並分類。非監督式學習常見的功能可為分群(Clustering)、關聯(Association)與降維(Dimension Reduction),在資料探勘初期是好用的工具,對人力的負擔較小,但對機器而言卻相反,且不重要的特徵容易被過度放大,預測結果容易出現偏差。
半監督式學習(Semi-Supervised Learning)
半監督式學習結合了監督式與非監督式學習的特點,僅為部分數據提供標註,以建立模型的學習基準。這種方法可以減少標註數據的需求,同時提高模型的準確度,因此在實務應用中相當常見。例如,從一組包含 100 張貓狗圖片的數據集中,隨機標註其中 10 張為「貓」或「狗」,機器可以利用這 10 張標註圖像來學習特徵,並推斷剩餘 90 張圖片的分類。這種方式通常比純非監督式學習的結果更準確,但又比完全監督式學習所需的數據量少。
強化學習(Reinforcement Learning)
強化式學習的運作方式,是讓機器直接與環境互動,從中去學習以取得預期的結果。這種學習方式,不須進行標註,而是告訴電腦哪一步是正確,哪一步是錯的,讓機器逐一修正並自我學習,進而得出回饋及越來越有效率達成目標。
以非監督式學習來說,強化式學習就顯得格外重要,像是要機器自行學習辨識特徵,機器將狗的照片預測為貓,這時由人給予機器指正,讓機器從錯誤中學習,以此學習正確的分類和辨識,如此預測會更加精準可靠。
以非監督式學習來說,強化式學習就顯得格外重要,像是要機器自行學習辨識特徵,機器將狗的照片預測為貓,這時由人給予機器指正,讓機器從錯誤中學習,以此學習正確的分類和辨識,如此預測會更加精準可靠。
機器學習的應用
機器學習已被廣泛應用於各種領域,包括:
影像識別
訓練機器學習演算法來識別圖像中的物體、人臉及其他特徵。
自然語言處理(NLP)
使機器能夠分析與理解人類語言,應用於聊天機器人、語音助理等。
預測分析
根據歷史數據中的模式來預測未來事件或行為,如市場趨勢預測。
詐欺偵測
在金融交易中運用機器學習來檢測並預防詐欺行為。
醫學診斷
訓練演算法分析醫學影像,以協助醫生診斷疾病。
總結
機器學習是一項強大技術,正在徹底改變我們解決複雜問題的方式。透過讓電腦從數據中學習,我們可以開發出能夠做出準確預測與決策的演算法。然而,監督式、非監督式、半監督式與強化學習只是機器學習的基本分類。在實際應用中,選擇哪種學習方法取決於多種因素,例如數據的可用性、計算資源以及專案目標。因此,在選擇機器學習方法時,最關鍵的問題永遠是:「我們要解決什麼問題?」